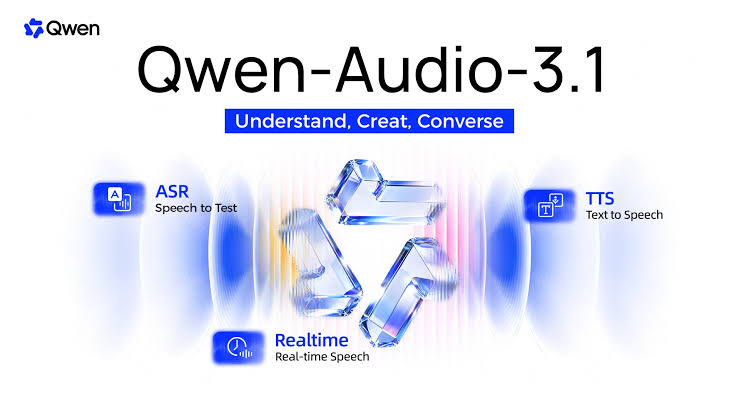

علیبابا روز چهارشنبه از مجموعه جدید Qwen-Audio-۳.۱ رونمایی کرد؛ پنج مدل صوتی که قرار است بخشهای مختلف کار با صدا را پوشش دهند، از تبدیل گفتار به متن و ساخت صدای طبیعی گرفته تا مکالمهی زنده و تولید یک صحنهی صوتی کامل.
همزمان با این معرفی، علیبابا قیمت سرویسهای صوتی خود را هم پایین آورده است. طبق اعلام این شرکت، قیمت TTS حدود ۷۰ درصد، Realtime حدود ۸۵ درصد و ASR تا ۹۵ درصد کاهش پیدا کرده است. اگر این کاهش قیمتها در استفادهی واقعی هم همینقدر محسوس باشند، ساخت دستیار صوتی، پادکست یا کتاب صوتی برای تیمهای کوچک میتواند هزینهی خیلی کمتری داشته باشد.
پست رسمی Qwen درباره معرفی Qwen-Audio-۳.۱
با این حال، یک نکته از همین ابتدا مهم است: بخش قابل توجهی از اعداد و ادعاهای مربوط به مدلهای جدید هنوز از خود علیبابا میآیند. برای بعضی از قابلیتهای تازه، مخصوصاً ASR-Next و TTS-Next، هنوز ارزیابی مستقل گستردهای در دسترس نیست.
پنج مدل برای یک زنجیره صوتی
Qwen-Audio-۳.۱ در واقع یک مدل واحد نیست. علیبابا سه بخش قبلی خود یعنی ASR، TTS و Realtime را بهروزرسانی کرده و در کنار آنها دو مدل جدید با نامهای ASR-Next و TTS-Next را هم معرفی کرده است.
ASR وظیفهی فهمیدن گفتار را دارد، TTS متن را به صدا تبدیل میکند و Realtime برای مکالمهی صوتی زنده ساخته شده. دو مدل جدید کمی متفاوتاند: ASR-Next قرار است محتوای صوتی را عمیقتر تحلیل کند و TTS-Next به سمت ساخت یک قطعهی صوتی کامل میرود.
علیبابا این مجموعه را یک «پشتهی کامل صوتی» توصیف میکند؛ از فهم و تولید صدا گرفته تا تعامل و ساخت محتوای صوتی.
ASR فقط صدا را به متن تبدیل نمیکند
مدل ASR جدید از ۳۰ زبان و ۱۶ گویش چینی پشتیبانی میکند و طبق اعلام علیبابا، اولین کلمهی خروجی را حدود ۱۶۰ میلیثانیه بعد از دریافت صدا تولید میکند.
اما چیزی که برای استفادههای واقعی مهمتر است، نحوهی برخورد مدل با گفتوگوی طبیعی است. آدمها هنگام صحبت کردن مکث میکنند، کلمهای را تکرار میکنند، وسط جمله نظرشان عوض میشود یا یک عبارت را اصلاح میکنند. ASR-۳.۱ میتواند این موارد را در متن نهایی مرتب کند و بخشی از تکرارها و کلمات پرکننده را کنار بگذارد.
برای جلسه و مصاحبه هم مدل میتواند متن صحبتها، زمانبندی و برچسب گوینده را کنار هم تولید کند. حتی در شرایطی که افراد روی حرف هم میپرند یا چند صدای همزمان در فایل وجود دارد، مدل برای تفکیک نوبتهای صحبت طراحی شده است.
یک قابلیت دیگر هم مربوط به اصطلاحات تخصصی است. اگر در یک فایل طولانی اسمها یا مخففهای خاصی چند بار تکرار شوند، سیستم میتواند از سابقهی صوتی استفاده کند تا این موارد در متن نهایی یکدستتر بمانند.
علیبابا برای عملکرد ASR هم عددهایی منتشر کرده است. در توضیحات منتشرشده درباره Qwen-Audio-۳.۱، میانگین نرخ خطای نویسه در مجموعههای عمومی مربوط به گویشهای چینی ۴.۵۵ درصد اعلام شده و مدل در شش زیرمجموعه بهترین نتیجه را گرفته است. در آزمایش داخلی علیبابا روی ۱۶ گویش نیز میانگین خطای ۱۰.۳۸ درصد گزارش شده است.
در مورد تفکیک گوینده، مقایسهی اصلی شرکت با مدل قبلی خودش، Fun-ASR، انجام شده است.
ASR-Next دنبال صدای پسزمینه هم میگردد
ASR-Next داستان متفاوتی دارد. این مدل قرار نیست فقط بفهمد یک نفر چه گفته است.
میتواند به خود محیط صوتی هم نگاه کند؛ مثلاً صدای موسیقی، ماشین، محیط یا اتفاقاتی که در پسزمینهی یک مکالمه رخ میدهند. مدل میتواند دربارهی این صداها توضیح بدهد، زمان وقوعشان را مشخص کند و دربارهی محتوای فایل صوتی به سؤال جواب بدهد.
در نمونهای که علیبابا ارائه کرده، فایل شامل گفتوگو، موسیقی پسزمینه و صداهای محیطی است. خروجی مدل هم متن مکالمه را مشخص میکند و هم توضیح میدهد صداهای دیگر چه بودهاند و چه زمانی شنیده شدهاند.
این تفاوت کوچکی نیست. یک سیستم تبدیل گفتار به متن بیشتر به این سؤال جواب میدهد که «چه چیزی گفته شد؟» اما ASR-Next میخواهد به سؤالهای بیشتری دربارهی خود فایل صوتی جواب بدهد؛ از جمله اینکه چه اتفاقی در محیط افتاده یا چه احساسی در صدای گوینده وجود داشته است.
Qwen در TTS دنبال صدای طبیعیتر نیست؛ دنبال کنترل بیشتر است
در بخش تولید صدا، Qwen-Audio-۳.۱-TTS ادامهی مسیری است که علیبابا با نسل قبلی شروع کرده بود.
Qwen-Audio-۳.۰-TTS در ماه ژوئیه در دو نسخه Flash و Plus معرفی شد. Flash برای سرعت و استفادههای تعاملی ساخته شده بود و Plus بیشتر روی کیفیت تمرکز داشت. آن مدل از ۱۶ زبان پشتیبانی میکرد؛ از عربی و انگلیسی گرفته تا آلمانی، فرانسوی، ایتالیایی، ژاپنی، کرهای، روسی، اسپانیایی، تایلندی و ویتنامی.
فارسی در این فهرست قرار ندارد. فهرست زبانهای پشتیبانیشده Qwen-Audio-۳.۰-TTS این موضوع را نشان میدهد.
نسخهی ۳.۱ همچنان روی چندزبانه بودن و کنترل صدا تمرکز دارد، اما یکی از قابلیتهایی که علیبابا روی آن مانور میدهد، حفظ هویت یک صدا در زبانهای مختلف است.
یعنی میتوانید نمونهای از صدای یک گوینده را داشته باشید و همان صدا را برای صحبت کردن به زبانهای مختلف استفاده کنید. علاوه بر متن، کاربر میتواند با دستور متنی چیزهایی مثل احساس، سرعت و سبک صحبت کردن را کنترل کند.
۸۶ برچسب کنترلی درونمتنی هم برای کنترل جزئیتر در اختیار کاربر قرار گرفته است. این برچسبها میتوانند رفتارهایی مثل خنده، نفس کشیدن، سرفه یا آه کشیدن را کنترل کنند.
مدل همچنین برای کار با نمونههای صوتی دارای نویز یا انعکاس زیاد طراحی شده و علیبابا میگوید در چنین شرایطی لزوماً به یک مرحلهی جداگانه برای حذف نویز احتیاج ندارد.
نسخهی ۳.۱ همان ۱۶ زبان، ۲۰ گویش چینی و امکان تولید یکجای فایلهای صوتی طولانی تا سه دقیقه را در وبلاگ فنی Qwen-Audio-۳.۱ TTS ذکر میکند.
TTS-Next میخواهد صدای یک صحنه را کامل بسازد
اما TTS-Next احتمالاً متفاوتترین عضو این خانواده است.
در یک سیستم معمولی TTS، شما متن را وارد میکنید و یک صدای گوینده تحویل میگیرید. اگر بخواهید همان صدا موسیقی پسزمینه، صدای باد، صدای خیابان یا یک افکت خاص هم داشته باشد، باید سراغ ابزارهای دیگری بروید و در نهایت همه چیز را با هم میکس کنید.
TTS-Next ایدهی دیگری دارد.
علیبابا میگوید این مدل میتواند گفتار، جلوههای صوتی و صدای محیط را در یک مرحله تولید کند. مستندات رسمی Alibaba Cloud درباره TTS-Next هم آن را مدلی برای تولید یکجای محتوای صوتی معرفی میکند که میتواند از متن، زمانبندی و صدای مرجع استفاده کند و گفتار، افکت و صدای محیط را در یک خروجی ترکیب کند.
نمونهای که علیبابا نشان داده، یک کتاب صوتی است: یک راوی، دو شخصیت، صدای شهر در پسزمینه، نسیم غروب و حتی صدای برخورد یک قوطی.
نکته فقط تولید این صداها نیست. مدل باید شخصیتها را در طول مکالمه ثابت نگه دارد تا صدای یک کاراکتر ناگهان تغییر نکند. مکثها، نوبت صحبت کردن و تغییر احساس هم باید با داستان هماهنگ بمانند.
خروجی TTS-Next با نرخ ۴۸ کیلوهرتز تولید میشود و علیبابا کاربردهایی مثل پادکست، کتاب صوتی، فیلم و سریال، بازی و تبلیغات را برای آن در نظر گرفته است.
در اطلاعیه رسمی Alibaba درباره Qwen-Audio-۳.۱ و TTS-Next از قابلیت تولید «صحنههای صوتی سینمایی» صحبت شده است.
البته اینجا همان احتیاط قبلی مهم است. اینکه مدل بتواند در یک نمونهی نمایشی چنین صحنهای بسازد، با اینکه بتواند همین کیفیت و ثبات را برای صدها دقیقه محتوای واقعی حفظ کند، دو موضوع متفاوت است. برای نسخهی جدید هنوز ارزیابی مستقل کافی وجود ندارد.
Realtime؛ وقتی دستیار صوتی وسط حرف شما نمیایستد
مدل Realtime برای مکالمهی زنده ساخته شده و قرار نیست تجربهاش شبیه این باشد که شما سؤال بپرسید، چند ثانیه سکوت کنید و بعد یک پاسخ کامل تحویل بگیرید.
مدل همزمان گوش میدهد و صحبت میکند و کاربر میتواند وسط پاسخ آن وارد مکالمه شود.
این موضوع برای دستیارهای صوتی اهمیت زیادی دارد. در مکالمهی واقعی، آدمها منتظر نمیمانند طرف مقابل همیشه جملهاش را کامل کند. ممکن است وسط حرف بپرند، سؤال را اصلاح کنند یا مسیر بحث را عوض کنند.
علیبابا همچنین میگوید مدل میتواند از روی لحن کاربر وضعیت احساسی او را تشخیص دهد. برای مثال، اگر صدای کاربر غمگین باشد، پاسخ میتواند با سرعت و لحن متفاوتی ارائه شود.
در مکالمههای چندزبانه، سابقهی گفتوگو و سبک صدا هم حفظ میشود.
Realtime علاوه بر مکالمه میتواند به ابزارهای خارجی هم متصل شود؛ از API و پایگاه دانش گرفته تا سامانههای کسبوکار. یعنی دستیار میتواند اطلاعاتی را از یک سرویس بگیرد و نتیجه را دوباره در همان مکالمه به کاربر بگوید.
طبق اطلاعات منتشرشده درباره نسخهی Plus، این مدل پنجرهی متنی ۲۶۲ هزار توکنی دارد و از مکالمهی همزمان دوطرفه، فراخوانی تابع، جستوجوی وب و شبیهسازی صدا پشتیبانی میکند.
با این حال، یک نکته در مستندات فعلی Alibaba Cloud برای مدلهای Realtime وجود دارد که ارزش توجه دارد: مستندات فعلی پشتیبانی از function calling را تأیید میکنند، اما جستوجوی وب را برای Qwen-Audio Realtime در همان صفحه پشتیبانیشده نمیدانند و این قابلیت را برای برخی مدلهای Omni ذکر میکنند. بنابراین ادعای «جستوجوی وب» را بهتر است تا زمان روشن شدن مستندات نسخهی ۳.۱ با احتیاط نقل کرد.
علیبابا میگوید فناوری Realtime را در محصولاتی مثل Qoder و QwenWork و همچنین دستگاههایی مانند QwenNote و عینک هوشمند Qwen به کار گرفته است.
قیمتها پایین آمدهاند، اما عدد ۹۵ درصد یک توضیح مهم کم دارد
شاید برای توسعهدهندگان، بخش قیمت حتی از خود مدلها مهمتر باشد.
علیبابا میگوید قیمت TTS حدود ۷۰ درصد، Realtime حدود ۸۵ درصد و ASR تا ۹۵ درصد کاهش پیدا کرده است. گزارش منتشرشده درباره کاهش قیمت Qwen-Audio نیز همین اعداد را از اطلاعیه Qwen نقل کرده است.
اما درصد بهتنهایی کافی نیست.
در منابعی که برای این گزارش بررسی شد، مشخص نبود همهی این درصدها دقیقاً نسبت به کدام قیمت پایه محاسبه شدهاند. بنابراین نمیشود صرفاً با دیدن عدد «۹۵ درصد» نتیجه گرفت که هر پروژهای دقیقاً ۹۵ درصد ارزانتر خواهد شد.
برای مقایسه، Qwen-Audio-۳.۰-TTS Plus پیش از این حدود ۲۷.۵۹ دلار به ازای هر یک میلیون نویسه قیمت داشت. این مدل در زمان عرضه در رتبهبندی Artificial Analysis هم امتیاز Elo حدود ۱۲۳۶ گرفته بود.
در آن ارزیابی، Qwen-Audio-۳.۰-TTS Plus با اختلاف کمی بالاتر از Simba ۳.۲ و مدلهایی مانند Gemini ۳.۱ Flash TTS قرار گرفت. بازهی اطمینان نتایج نیز با برخی مدلها همپوشانی داشت؛ بنابراین آن رتبه را نباید بهعنوان فاصلهی قطعی کیفیت بین مدلها در نظر گرفت.
سرعت تولید هم نقطه قوت اصلی نسخهی Plus نبود. سرعت آن حدود ۱۶ نویسه در ثانیه گزارش شده بود، در حالی که Simba ۳.۲ حدود ۳۰.۲ و Sonic ۳.۵ حدود ۱۲۰ نویسه در ثانیه ثبت کرده بودند. گزارش Marktechpost درباره Qwen-Audio-۳.۰-TTS این نتایج را به نقل از ارزیابیهای منتشرشده گزارش کرده است.
برای خود Qwen-Audio-۳.۱ هنوز دادهی مستقل کافی برای مقایسهی مستقیم با این مدلها منتشر نشده است.
علیبابا همزمان روی ترجمهی زنده کار میکند
این معرفی در خلأ اتفاق نیفتاده است. علیبابا در کنفرانس Apsara ۲۰۲۶ همزمان از Qwen3.۸-LiveTranslate رونمایی کرد.
طبق اعلام شرکت، این سیستم تأخیر ترجمه را از حدود ۲.۸ ثانیه به ۲.۳ ثانیه رسانده است. گزارش Pandaily درباره Qwen-LiveTranslate و Qwen-Audio-۳.۱ جزئیات این معرفی را پوشش داده است.
این بخش با مسیر کلی Qwen-Audio-۳.۱ هم جور درمیآید: علیبابا فقط نمیخواهد یک مدل تبدیل متن به گفتار داشته باشد، بلکه در حال ساخت مجموعهای از مدلها برای شنیدن، صحبت کردن، ترجمه و تعامل صوتی است.
فعلاً همه چیز آماده استفاده نیست
یک محدودیت عملی هم وجود دارد.
پست معرفی Qwen برای ASR و Realtime صفحههای مشخصی را لینک کرده، اما دربارهی بعضی از APIهای دیگر نوشته شده که بهزودی در دسترس قرار میگیرند. گزارش AIbase درباره عرضه Qwen-Audio-۳.۱ نیز به وضعیت دسترسی مدلها اشاره کرده است.
در نتیجه، Qwen-Audio-۳.۱ را فعلاً باید بیشتر بهعنوان یک حرکت بزرگ در مجموعه صوتی Qwen دید تا محصولی که تمام قابلیتهای تبلیغشدهاش همین حالا در اختیار همه قرار گرفته است.
چیزی که علیبابا این بار ساخته، فقط یک مدل بهتر برای تبدیل صدا به متن نیست. ASR برای فهم گفتار، ASR-Next برای فهم خودِ محیط صوتی، TTS برای ساخت صدا، TTS-Next برای تولید یک صحنهی صوتی و Realtime برای مکالمهی زنده کنار هم قرار گرفتهاند.
اگر مدلها در استفادهی واقعی همان چیزی باشند که علیبابا در نمونهها نشان داده، مرز بین «مدل گفتار» و «ابزار تولید محتوای صوتی» کمی جابهجا میشود.
اما فعلاً باید بخشی از این تصویر را با احتیاط دید. قیمتهای جدید و مشخصات فنی اعلام شدهاند، ولی برای قضاوت دربارهی کیفیت واقعی Qwen-Audio-۳.۱، مخصوصاً دو مدل جدید ASR-Next و TTS-Next، هنوز به آزمایشهای مستقل بیشتری نیاز داریم.
ما بعد از تست کردن این مدل نتیجه رو با شما به اشتراک میگذاریم.